این بار یک مدل محلی معرفی شده که فقط برای نمایشهای آزمایشگاهی نیست؛ میتواند روی یک لپتاپ مناسب، بدون اتصال دائمی به سرور، کد بنویسد، تصویر را تحلیل کند و با ابزارهای مختلف کار کند. شرکت Thinking Machines Lab دیروز، ۲۰ نوامبر ۲۰۲۶، مدل Inkling 2 Mini را منتشر کرد و فایل اصلی آن را هم برای دانلود در دسترس گذاشت.
چیزی که توجهم را جلب کرد، ترکیب توانایی بالا با حجم حدود ۲۰ گیگابایت است. البته «قابل اجرا روی لپتاپ» به معنی اجرا روی هر لپتاپی نیست؛ نسخه رسمی برای مکهای مجهز به Apple Silicon حداقل ۳۲ گیگابایت حافظه میخواهد و برای سیستمهای دیگر هم معمولاً ۳۲ گیگابایت حافظه گرافیکی پیشنهاد شده است.
مدل Inkling 2 Mini دقیقاً چه کاری انجام میدهد؟
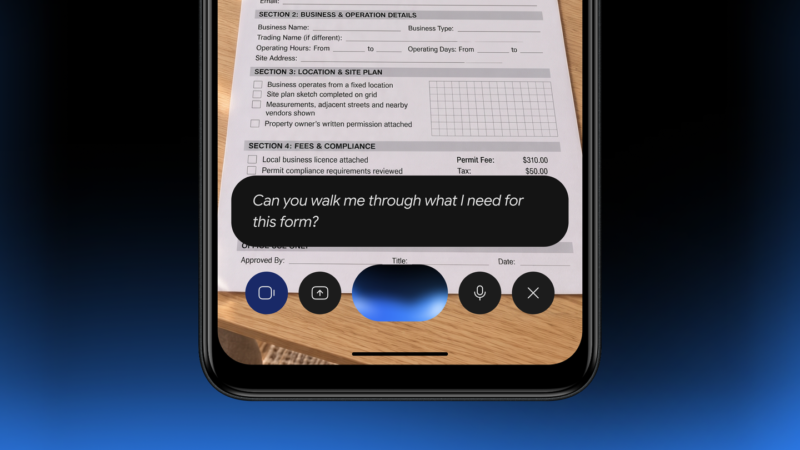
مدل Inkling 2 Mini متن و عکس را با هم میفهمد و پاسخ متنی تولید میکند. کاربرد اصلی آن برای برنامهنویسی، ساخت دستیارهای هوشمند، جستوجو در اسناد، تحلیل تصویر و انجام کارهای چندمرحلهای است. توسعهدهنده میتواند مدل را به ابزارهایی مثل جستوجوی وب، فایلها یا محیط برنامهنویسی وصل کند تا فقط پاسخ ندهد و بخشی از کار را هم انجام دهد.
نمونه رسمی شرکت نشان میدهد این مدل در حالت آفلاین روی یک MacBook Pro با تراشه M5 Pro و ۴۸ گیگابایت حافظه، یک شبیهساز پرواز قابل بازی ساخته است. این نتیجه یک آزمایش منتشرشده توسط سازنده است و نباید آن را تضمین کیفیت برای همه سیستمها یا همه پروژهها دانست.
این مدل تا یک میلیون واحد متنی را در یک درخواست میپذیرد؛ یعنی میتواند حجم بزرگی از کد یا اسناد را یکجا ببیند. با این حال، طول زیاد ورودی به معنی پاسخ بیخطا نیست و مصرف حافظه و زمان پردازش را هم بیشتر میکند.
ترفند متفاوت مدل برای فکر کردن بیشتر با فایل کوچکتر
بخش فنی جالب Inkling 2 Mini این است که دوازده لایه میانی خود را سه بار اجرا میکند. اگر ساده بگوییم، مدل به جای نگهداری چند مجموعه بزرگ و جدا از لایهها، همان بخش میانی را چند بار مرور میکند تا روی مسئله بیشتر کار کند. به همین دلیل فایل مدل نسبتاً کوچک میماند، اما محاسبه هر پاسخ همچنان سبک نیست.
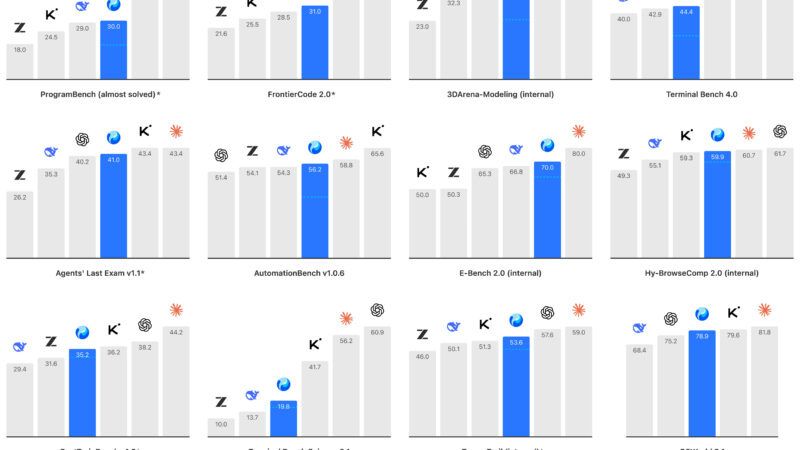
مدل در مجموع حدود ۲۶٫۴ میلیارد بخش عددی دارد، ولی در هر مرحله فقط بخش کوچکی از آن فعال میشود. این طراحی باعث میشود حافظه و توان پردازشی هدفمندتر مصرف شود. سازنده میگوید Inkling 2 Mini در چند آزمون برنامهنویسی و جستوجوی چندمرحلهای از مدلهای قابل دانلود هماندازه جلوتر بوده است. این اعداد از ارزیابیهای منتشرشده توسط خود شرکت میآیند و نتیجه واقعی به نرمافزار اجرا، سختافزار و نوع کار بستگی دارد.
دسترسی، قیمت و سختافزار لازم
فایل اصلی مدل در Hugging Face منتشر شده و مجوز Apache 2.0 دارد. بنابراین دانلود، تغییر و استفاده تجاری از آن با رعایت شرایط همین مجوز ممکن است. خود فایل مدل رایگان است، اما اجرای محلی رایگانِ واقعی به سختافزار مناسب و برق نیاز دارد.
کاربران مک میتوانند نسخه محلی را با Ollama یا ابزارهای سازگار اجرا کنند. نسخههای فشردهتر برای llama.cpp و Unsloth هم منتشر شدهاند. کاربران حرفهایتر روی کارتهای NVIDIA میتوانند از ابزارهایی مثل SGLang و vLLM استفاده کنند. اگر قبلاً مدلهای محلی را اجرا نکردهاید، راهنمای اجرای هوش مصنوعی روی کامپیوتر با LM Studio دید خوبی از تفاوت مدل محلی و سرویس ابری میدهد، هرچند پشتیبانی مستقیم این مدل در هر برنامه باید جداگانه بررسی شود.
یک محیط آنلاین به نام Tinker Playground هم برای گفتوگو با مدل در دسترس است و به حساب کاربری نیاز دارد. سرویس Tinker برای اجرا و شخصیسازی ابری بر اساس میزان مصرف قیمتگذاری میشود. در زمان انتشار این مطلب، قیمت مشخص و مستقلی برای استفاده از Inkling 2 Mini در صفحه اعلام مدل درج نشده بود؛ بنابراین نباید دسترسی آنلاین آن را کاملاً رایگان فرض کرد.
محدودیتهایی که قبل از نصب باید بدانید
مهمترین محدودیت، نیاز سختافزاری است. حداقل ۳۲ گیگابایت حافظه برای بسیاری از لپتاپهای معمولی عدد بالایی محسوب میشود. پشتیبانی از مدلهای حلقهای هم تازه است و سرعت اجرا بین Ollama، llama.cpp، سیستمهای مک و کارتهای NVIDIA میتواند تفاوت زیادی داشته باشد.
خود سازنده میگوید مدل در گفتوگوهای طولانی چندمرحلهای و دستورهایی با محدودیتهای زیاد، همیشه بهترین مدل هماندازه نیست. دانش عمومی و دقت واقعیتگویی آن نیز از مدل بزرگتر Inkling 2 Small پایینتر است و ممکن است اطلاعات نادرست را با اطمینان بیان کند.
محدودیت مهم دیگر برای کاربران فارسیزبان است. مدل پشتیبانی چندزبانه عمومی دارد، اما شرکت کیفیت پایینتر در زبانهای غیرانگلیسی را تأیید کرده و ارزیابی مشخصی برای فارسی منتشر نشده است. پس پیش از استفاده جدی باید کیفیت فارسی، درک دستورها و خروجی کد را با نمونههای واقعی خودتان بسنجید.
اگر مدل را به فایلها یا ابزارهای سیستم وصل میکنید، اجرای آن در محیط جدا و گرفتن تأیید قبل از حذف یا بازنویسی فایلها ضروری است. در کارت رسمی مدل آمده که عامل هوشمند ممکن است بدون تأیید، فایل را حذف یا جایگزین کند و حتی نتیجه کار را دقیق گزارش ندهد. برای تصمیمهای پزشکی، حقوقی یا حساس هم نباید بدون بررسی انسانی به آن تکیه کرد.
این مدل برای چه کسانی مناسب است؟
مدل Inkling 2 Mini بیشتر برای برنامهنویسها، پژوهشگران و افرادی مناسب است که یک مک پرحافظه یا سیستم مجهز به کارت گرافیک مناسب دارند و میخواهند دادهها روی دستگاه خودشان بماند. برای ساخت دستیار کدنویسی آفلاین، تحلیل اسناد خصوصی یا آزمایش عاملهای محلی گزینه قابلتوجهی است.
برای کاربر عادی با لپتاپ ۸ یا ۱۶ گیگابایتی، استفاده از سرویس ابری یا مدل کوچکتر احتمالاً منطقیتر است. این انتشار فاصله میان مدلهای محلی و سرویسهای قدرتمند ابری را کمتر میکند، اما محدودیت حافظه، کیفیت پایینتر زبانهای غیرانگلیسی و نیاز به کنترل خروجی هنوز جدی هستند.
پرسشهای رایج درباره Inkling 2 Mini
آیا مدل Inkling 2 Mini رایگان است؟
فایل مدل با مجوز Apache 2.0 رایگان منتشر شده و امکان استفاده تجاری دارد. هزینه سختافزار، برق و سرویسهای ابری جداست و محیط Tinker را نباید بدون بررسی حساب و قیمت، رایگان فرض کرد.
آیا روی هر لپتاپی اجرا میشود؟
خیر. پشتیبانی رسمی محلی برای مکهای Apple Silicon با حداقل ۳۲ گیگابایت حافظه اعلام شده است. برای کارتهای گرافیک دیگر هم حدود ۳۲ گیگابایت حافظه گرافیکی پیشنهاد میشود، هرچند نسخههای فشرده ممکن است روی بعضی سیستمها شرایط متفاوتی داشته باشند.
آیا برای فارسی مناسب است؟
مدل بهصورت عمومی چندزبانه است، اما آزمون رسمی مشخصی برای فارسی منتشر نشده و سازنده افت کیفیت در زبانهای غیرانگلیسی را پذیرفته است. برای کار فارسی باید آن را با متنها و وظایف واقعی خودتان ارزیابی کنید.
منابع رسمی این خبر کداماند؟
جزئیات انتشار در اعلام رسمی Thinking Machines Lab، شرایط فنی و محدودیتها در کارت رسمی مدل و روشهای اجرا در راهنمای Hugging Face منتشر شده است.